
Равиль Ахтямов, к.э.н.
digital-экономист
Галлюцинация ИИ в финансах — это не только выдуманная цифра. Это уверенное утверждение, которое выглядит как работа: таблица заполнена, проценты посчитаны, ссылки стоят, но источник не отвечал, речь шла не о том объекте или не о той дате. Опаснее всего «тихое решение»: агент говорит «всё в порядке» там, где правильный ответ — «данных недостаточно».
Когда ИИ-агент проверяет заёмщика или DeFi-рынок, самый дорогой его ответ — не «не знаю», а уверенное «всё в порядке», под которым нет данных. Отказ видно сразу: дело уходит человеку. Уверенный вердикт без опоры проходит дальше, обрастает цифрами и попадает в отчёт.
Эту ошибку легко недооценить, потому что она выглядит как работа. Таблица заполнена, проценты посчитаны, ссылки на источники стоят. Проверить, ответил ли источник на самом деле и про тот ли объект шла речь, обычно никто не успевает.
Ниже — история одного исторического кейса из открытого бенчмарка CACE-Bench, на котором такую ошибку сначала совершил не проверяемый агент, а сам инструмент проверки.
Кейс H10: правильный ярлык по неправильной причине
Осенью 2025 года рухнул синтетический доллар xUSD: в ноябре он торговался около $0,26 вместо доллара. Кредитные рынки, принимавшие его в залог, понесли потери. Один из них — рынок USDC/xUSD на протоколе Morpho в сети Arbitrum. В бенчмарке это кейс H10.
Задача кейса простая. Представьте поставщика USDC в этот рынок за несколько дней до краха. Должен ли риск-агент сказать «не входить»? Один из признаков риска — концентрация долга на одном заёмщике.
Первая ошибка: уверенный ответ про не тот объект
Первая автоматическая реконструкция нацелилась на публичный волт, который выглядел как канал кредитования. Инструмент вернул «OK» и концентрацию 100%. Все числа сходились между собой. Только волт на дату проверки был полностью «холостым»: деньги лежали без дела и никому не выдавались. Свободный остаток посчитали залогом, и получился уверенный вердикт об объекте, который к вопросу не относился.
Вторая ошибка: сегодняшние данные вместо данных на дату
Кейс перенацелили на нужный рынок. Черновой ярлык был написан по текущему состоянию: сегодня почти 100% долга у одного адреса. Звучит как доказательство концентрации. Но вопрос задан про 27 октября 2025 года, за неделю с небольшим до краха.
Прочитанное прямо из блокчейна на блоке 393 757 551 выглядит иначе. В рынке было $26,2 млн предложения и $23,1 млн долга, загрузка 88%. Сегодняшний единственный заёмщик держал тогда около 3% долга. Другой адрес держал 89% ($20,6 млн) и закрыл позицию до краха.
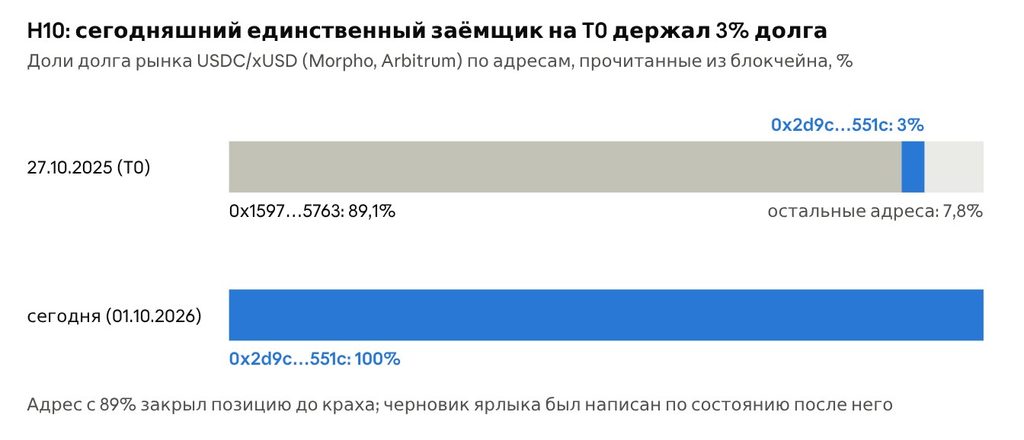
Рис. 1 Чтение из блокчейна Arbitrum на блоке 393 757 551 (27.10.2025) и текущее состояние на 01.10.2026. Источник: CACE-Bench, data/reconstructed/H10.json, data/defi_historical_v0.json
Ярлык «концентрация» устоял: она действительно была. А вот обоснование черновика было ложным. Агент, который пришёл бы к верному ответу этим путём, оказался бы прав случайно. На следующем рынке тот же метод ошибётся.
Почему «не знаю» — это правильный ответ
Большинство тестов для ИИ-агентов знают два исхода: угадал или нет. В такой схеме отказ всегда проигрывает, и агент учится отвечать всегда. CACE-Bench устроен иначе: у каждого кейса три допустимых вердикта. В DeFi это «входить», «не входить» и «данных недостаточно».
Третий вердикт — не уклонение, а правильный ответ, когда факты для решения получить нельзя. Если источник не ответил или вернул неполные данные, правильный агент передаёт дело человеку. Агент, который решает всё равно, получает ошибку «тихого решения». Отдельно наказывается ссылка на источник, который на самом деле не ответил.
Порядок величин виден в кредитной части того же бенчмарка. На синтетической выборке из 23 тыс. заявок эталонный агент без проверки решал больше половины дел, по которым данных не было, а цикл проверки сокращал эту долю почти на порядок. В DeFi-части картина та же. Это синтетика и иллюстрация метода, а не оценка реальной системы. Но разница показывает, насколько охотно агент заполняет пустоту уверенностью.
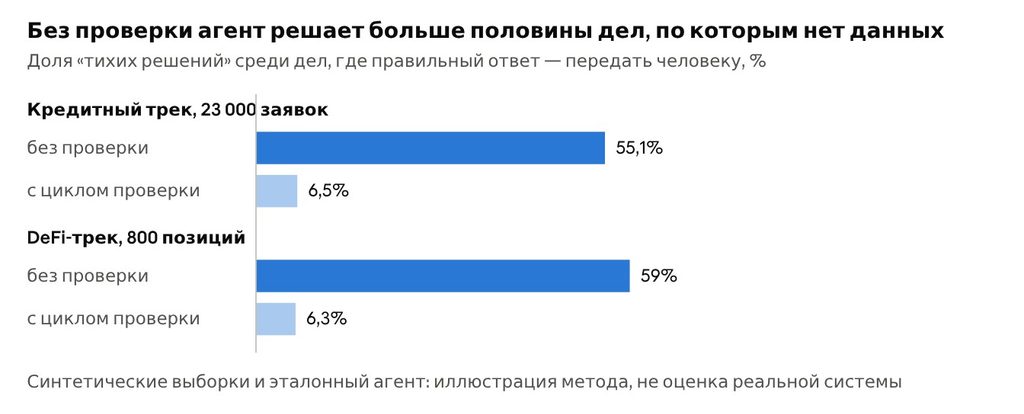
Рис. 2. CACE-Bench: кредитный трек v0.3.0, seed 0, N = 23 000 (results/REPORT-2026-08-03.md); DeFi-трек 0.5.0-draft, seed 0, N = 800 (defi_track.py)
После H10 в методологию добавили правило: внешний API может подсказать, какие адреса проверить, но ни одна сумма из API не идёт в обоснование. Каждая цифра читается из блокчейна на блоке перед событием и сопровождается «капсулой»: контракт, функция, блок и хеш ответа. Инструмент реконструкции теперь отказывается работать с холостыми волтами, а не возвращает по ним «OK».
Почему ИИ отвечает уверенно, когда данных недостаточно?
Потому что в большинстве тестов и метрик отказ проигрывает: «угадал / не угадал», а «не знаю» считается ошибкой. Агент быстро учится всегда отвечать, а не всегда проверять. Уверенный ответ дешевле честного «данных нет»: он проходит дальше, обрастает цифрами и попадает в отчёт. CACE-Bench меняет стимул: третий вердикт ESCALATE — это правильный ответ, когда фактов для решения нет; ссылка на неответивший источник наказывается отдельно. В референсном прогоне silent-decision rate падал с 55,11% до 6,53% при включённом цикле проверки — то есть проблема не столько в «слабости модели», сколько в дизайне оценки.
Что из этого следует
Для банков и финтеха
Метрика «доля автоматически решённых дел» поощряет ровно ту ошибку, о которой речь. Рядом с ней нужна вторая: какая доля решений принята при неполных данных. Если поставщик решения называет высокий процент автоматизации и не называет второго числа, вопрос «по сравнению с чем?» остаётся без ответа.
Для надзора
Требование объяснимости решений обычно читается как «покажите, почему». H10 показывает, что этого мало: объяснение может быть связным и при этом относиться не к тому объекту или не к той дате. Проверяемое объяснение ссылается на источник, который ответил, и на момент, к которому вопрос задан.
Для DeFi-кураторов и риск-команд
Метрики ликвидности и концентрации по текущему состоянию рынка отвечают на вопрос «что сейчас», а не «что было видно тогда». Ретроспективные разборы инцидентов, написанные по сегодняшним данным, могут быть правы по выводу и неправы по причине. Для обучения агентов такие разборы опасны: они учат правильному ярлыку через неправильный признак.
Вместо вывода
Самая полезная находка этого кейса в том, что первым «тихое решение» принял сам инструмент проверки. Ошибка не в слабости модели, а в том, что уверенный ответ дешевле честного «данных нет». Пока системы оцениваются по доле решённого, они будут выбирать уверенность.
CACE-Bench открыт: кейсы, методология и код судьи опубликованы, любую цифру можно перепроверить по блокчейну. Если ваш агент принимает решения о кредитах или DeFi-позициях, его можно прогнать на тех же кейсах — и посмотреть, сколько раз он скажет «не знаю», когда это правильный ответ.
CACE-Bench — открытый синтетический бенчмарк для агентов кредитного и DeFi-риска. Он генерирует кейсы, прогоняет пайплайн и судит не только финальный вердикт, но и весь след решения. В кредитном треке — 23 000 заявок; в DeFi — синтетический и исторический сплиты. У кейса три допустимых исхода: FLAG / CLEAR / ESCALATE (в DeFi — GO / NO-GO / INSUFFICIENT_DATA). Метрики: silent-decision rate, provenance completeness, over-escalation, hallucination rate, recovery rate, compliance false-positive, step-level correctness.
В последнем релизе данные обогащены источниками ЛатАм: конфиг configs/providers.json описывает страновые цепочки для Бразилии, Мексики, Колумбии и Эквадора. Учитываются три класса сигналов — open_banking, alt_data, screening — и вероятность отказа или неполного ответа. Регуляторный маппинг: Bacen (BR), CNBV (MX), SFC (CO), SB/SEPS/UAFE (EC). Это позволяет проверять агента не в вакууме, а в условиях, когда источник в стране не отвечает, а решение всё равно должно быть отложено. Важно: в бенчмарк не попадают реальные данные провайдеров — только структура реестра и сценарии доступности.
Ключевые термины: CACE-Bench, ИИ-агент, кредитный риск, DeFi-риск, ESCALATE, аудит решений, ЛатАм, LatAm.
Не является инвестиционной рекомендацией и рейтингом какого-либо протокола. Исторические кейсы — публичные инциденты.
Подробнее: www.digitaleconomylab.ru · DeFi-трек бенчмарка: www.cauceia.com/defi
Статья является личным мнением автора и может не совпадать с мнением редакции.
Другие материалы Равиля Ахтямова:
Другие статьи Равиля Ахтямова:
- Оценка кредитного риска: IRB-подход, ML и формы 111, 106
- Архитектура кредитного конвейера 2.0: ИИ-агенты, BPM и микросервисы
- Внедрение ИИ в банках: архитектура кредитного конвейера 2.1
- Кредитный конвейер 2.2: система метрик качества для LLM-агентов
- Кредитный конвейер 2.3: когда агент учится сам
- Обрыв вместо наклона: как новые стресс-тесты Банка России изменят работу НПФ
Об авторе
Равиль Ахтямов — кандидат экономических наук, digital-экономист. Двадцать лет между двумя мирами, которые обычно друг друга не читают: банковский надзор и регуляторика — и производственный machine learning.
Отсюда и способ работы: регуляторное требование переводится в измеримый показатель, показатель проверяется на данных, а результат публикуется вместе с тем, чего он не доказывает. Такой оговоркой чаще всего и отличается инструмент от маркетингового процента.
Опыт включает участие в пилоте цифрового рубля, управление портфелями государственных проектов на 23 млрд рублей, запуск закрытых инвестиционных фондов недвижимости и построение проектных офисов в региональных правительствах — две национальные премии «Проектный Олимп» (2017 и 2021).
Степень: Кандидат экономических наук
Квалификация: Сертификат по финтеху, Университет Банка России
Квалификационный аттестат ФКЦБ России, серия 5.0ORCID0000-0002-0783-8573
Преподавание: Автор учебных программ, ведущие вузы России